
Meta AI
DINOv3
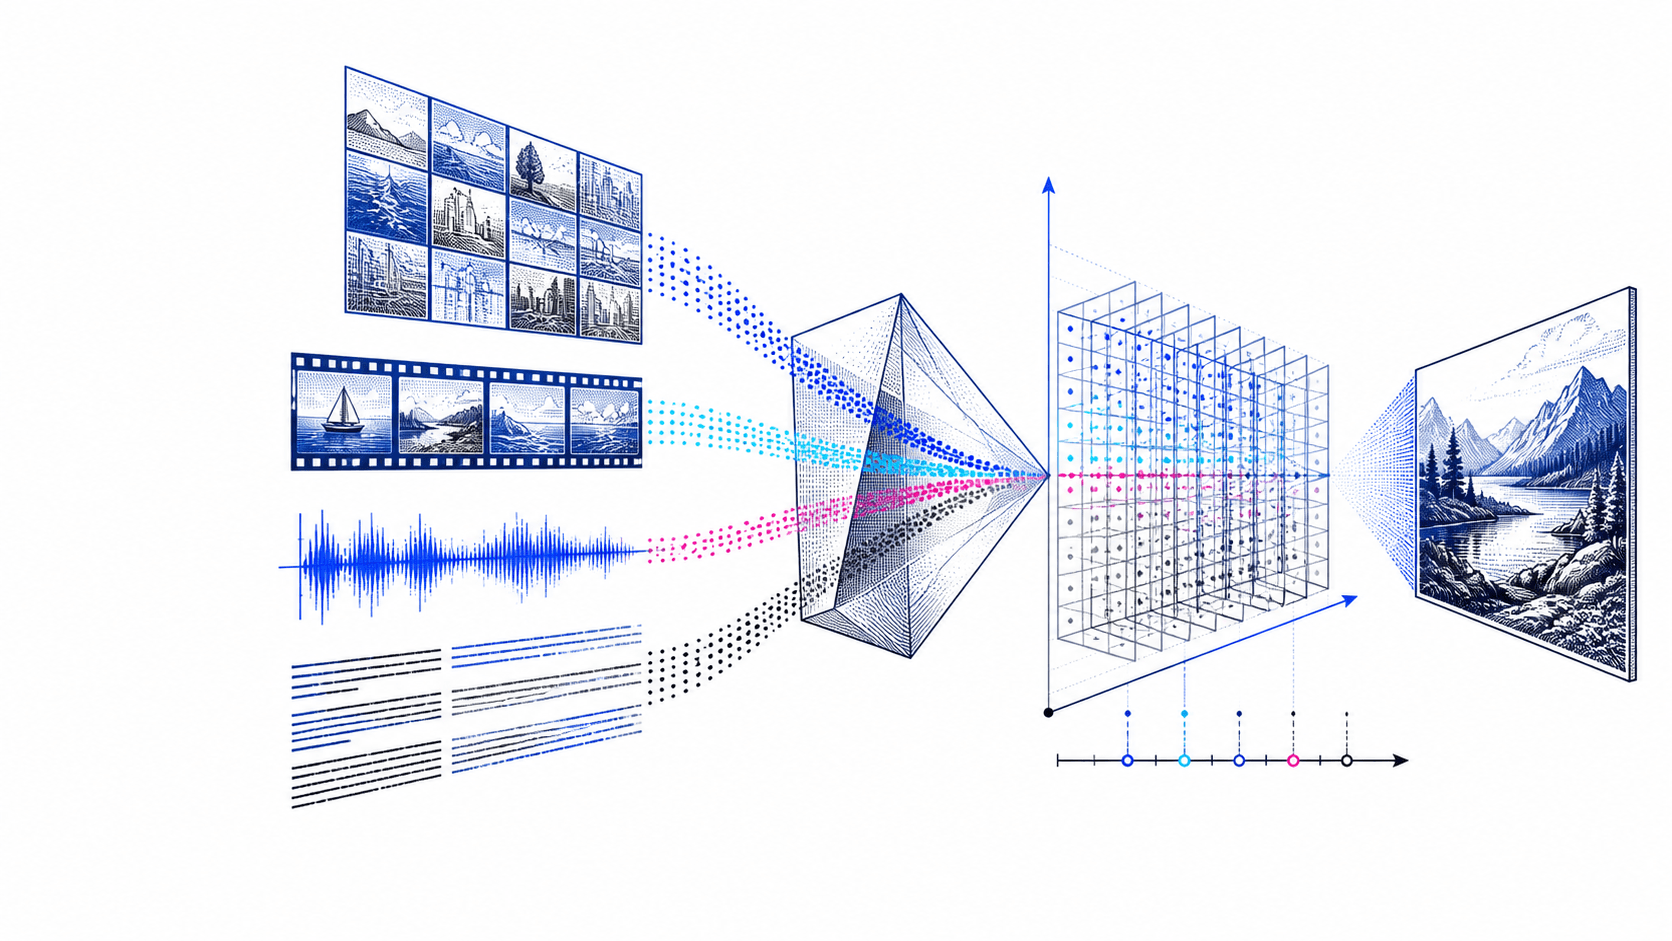
DINOv3 is a self-supervised vision foundation model that scales to 7B parameters, trained on a curated dataset of 1.689 billion images (LVD-1689M) from Instagram, combined with ImageNet-1k. The model uses a ViT architecture with RoPE embeddings and constant hyperparameter schedules. A key contribution is Gram anchoring, a regularization technique that…
Oriane Siméoni, Huy V. Vo, Maximilian Seitzer, Federico Baldassarre, et al.- Published
- Aug 2025
- Citations
- 1.2K
- Code
- 11K stars